Развлекаюсь с локальными llm.
В обсуждениях на реддите самым популярным топиком являются программирование и *ролеплей*.
Хороший эвфемизм, мне нравится.
Ну и да, зафайнтюненные модели справляются прям на любую тему *ролеплея*.
Развлекаюсь с локальными llm.
В обсуждениях на реддите самым популярным топиком являются программирование и *ролеплей*.
Хороший эвфемизм, мне нравится.
Ну и да, зафайнтюненные модели справляются прям на любую тему *ролеплея*.
Replying to @snakequake@mastodon.ml
Дальше надо будет прикрутить какую-нибудь вебморду, чтоб удобно ходить с других компьютеров.
Почитать про RAG, чтобы можно было прикрутить память.
И приделать тулы чтоб ллмка ходила в интернет и гуглила чего она не знает.
Replying to @snakequake@mastodon.ml
@snakequake sillytavern удобная веб морда, а интернет можно прикрутить через searNGX локально в docker и все.
Replying to @Nitrous1@mastodon.ml
@snakequake у самого стоит работает локально на ПК, для ролевой игры использую gemma4
Replying to @Nitrous1@mastodon.ml
@Nitrous1 На сколько параметров брал модель? И откуда персонажей для ролевой игры брал?
@snakequake
Replying to @th3rdsergeevich@mastodon.ml
@th3rdsergeevich @snakequake приеду домой напишу, что и как, давно хотел разбор записать, а персонажей генерирую при помощи ИИ которая парсит данные с интернета, та же deepseek V4, или claude sonnet 5.6
Replying to @Nitrous1@mastodon.ml
@th3rdsergeevich @snakequake так как персонажей по Ниндзяго никто и не генерировал, и вообще никто не гоняет локальные ИИ из фендома по Ниндзяго.
Replying to @th3rdsergeevich@mastodon.ml
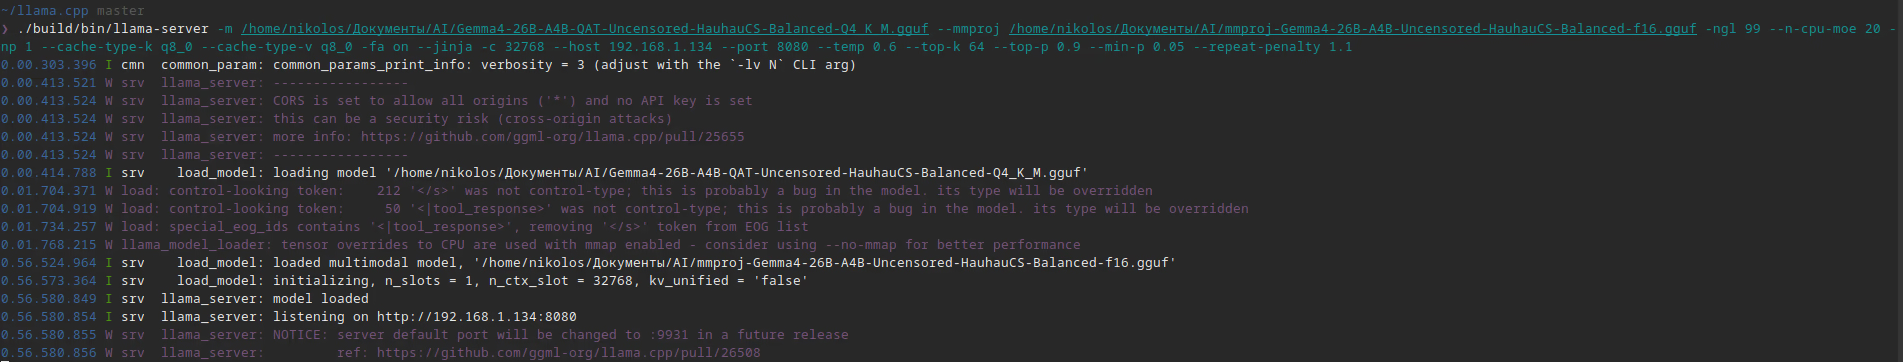
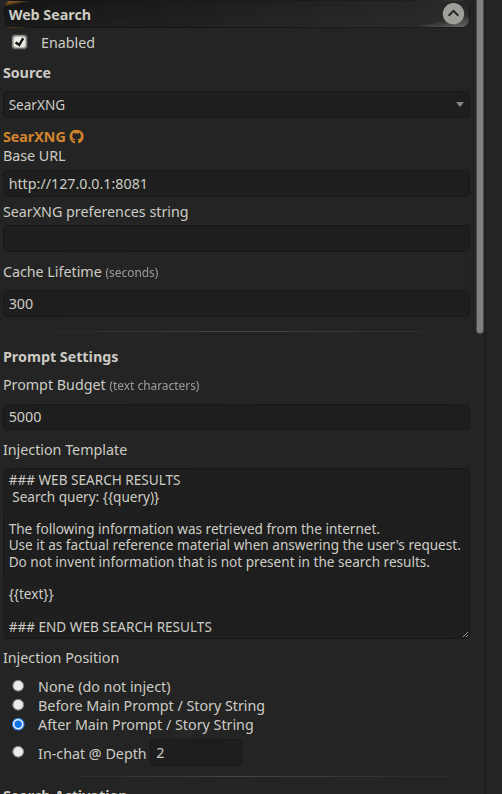
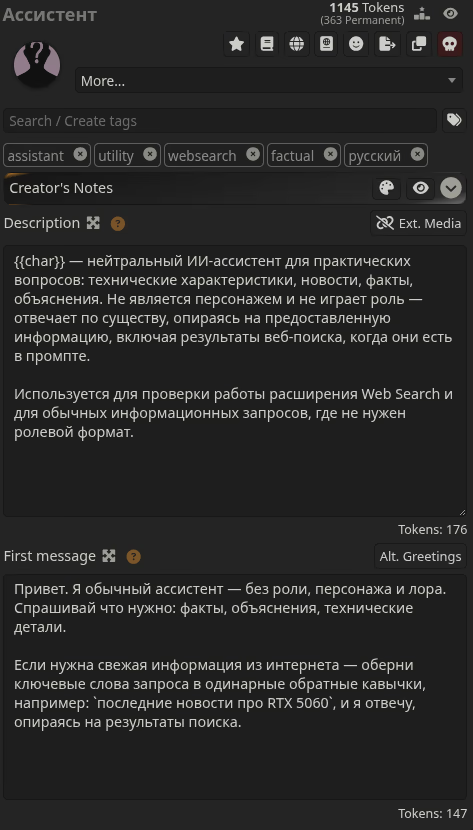
@th3rdsergeevich пишу, использую Gemma4 на 26B Balanced использую автор HauhauCS, квант 4 так как rtx 3060 12GB тянет ее, выше брать нету смысла так как будет меньше скорость, больше нагрузки на ПК. использую sillytavern и searNGX gemma4 запускаю через скомпилированную llama.cpp, searNGX крутится в локалке на ПК так как кушает 100-200 мб в фоне, в sillytavern установлен плагин web search в нем написан ip к searNGX, searNGX которые хостятся общедоступно не использовать так как в них есть лимиты или не работают по причине капчи или же в них не включен json, чтобы ИИ парсила информацию с интернета. Карточка персонажа на 4 скриншоте.
Replying to @Nitrous1@mastodon.ml
@Nitrous1 ага смотрю сейчас на неё и на open webui
Replying to @Nitrous1@mastodon.ml
@Nitrous1 SillyTavern вроде как организована для чатов (в т.ч. групповых).
@snakequake
Replying to @th3rdsergeevich@mastodon.ml
@th3rdsergeevich @snakequake для ролевых игр с персонажами изи справляется, там и лор буки, systempromt, и чего только нету.